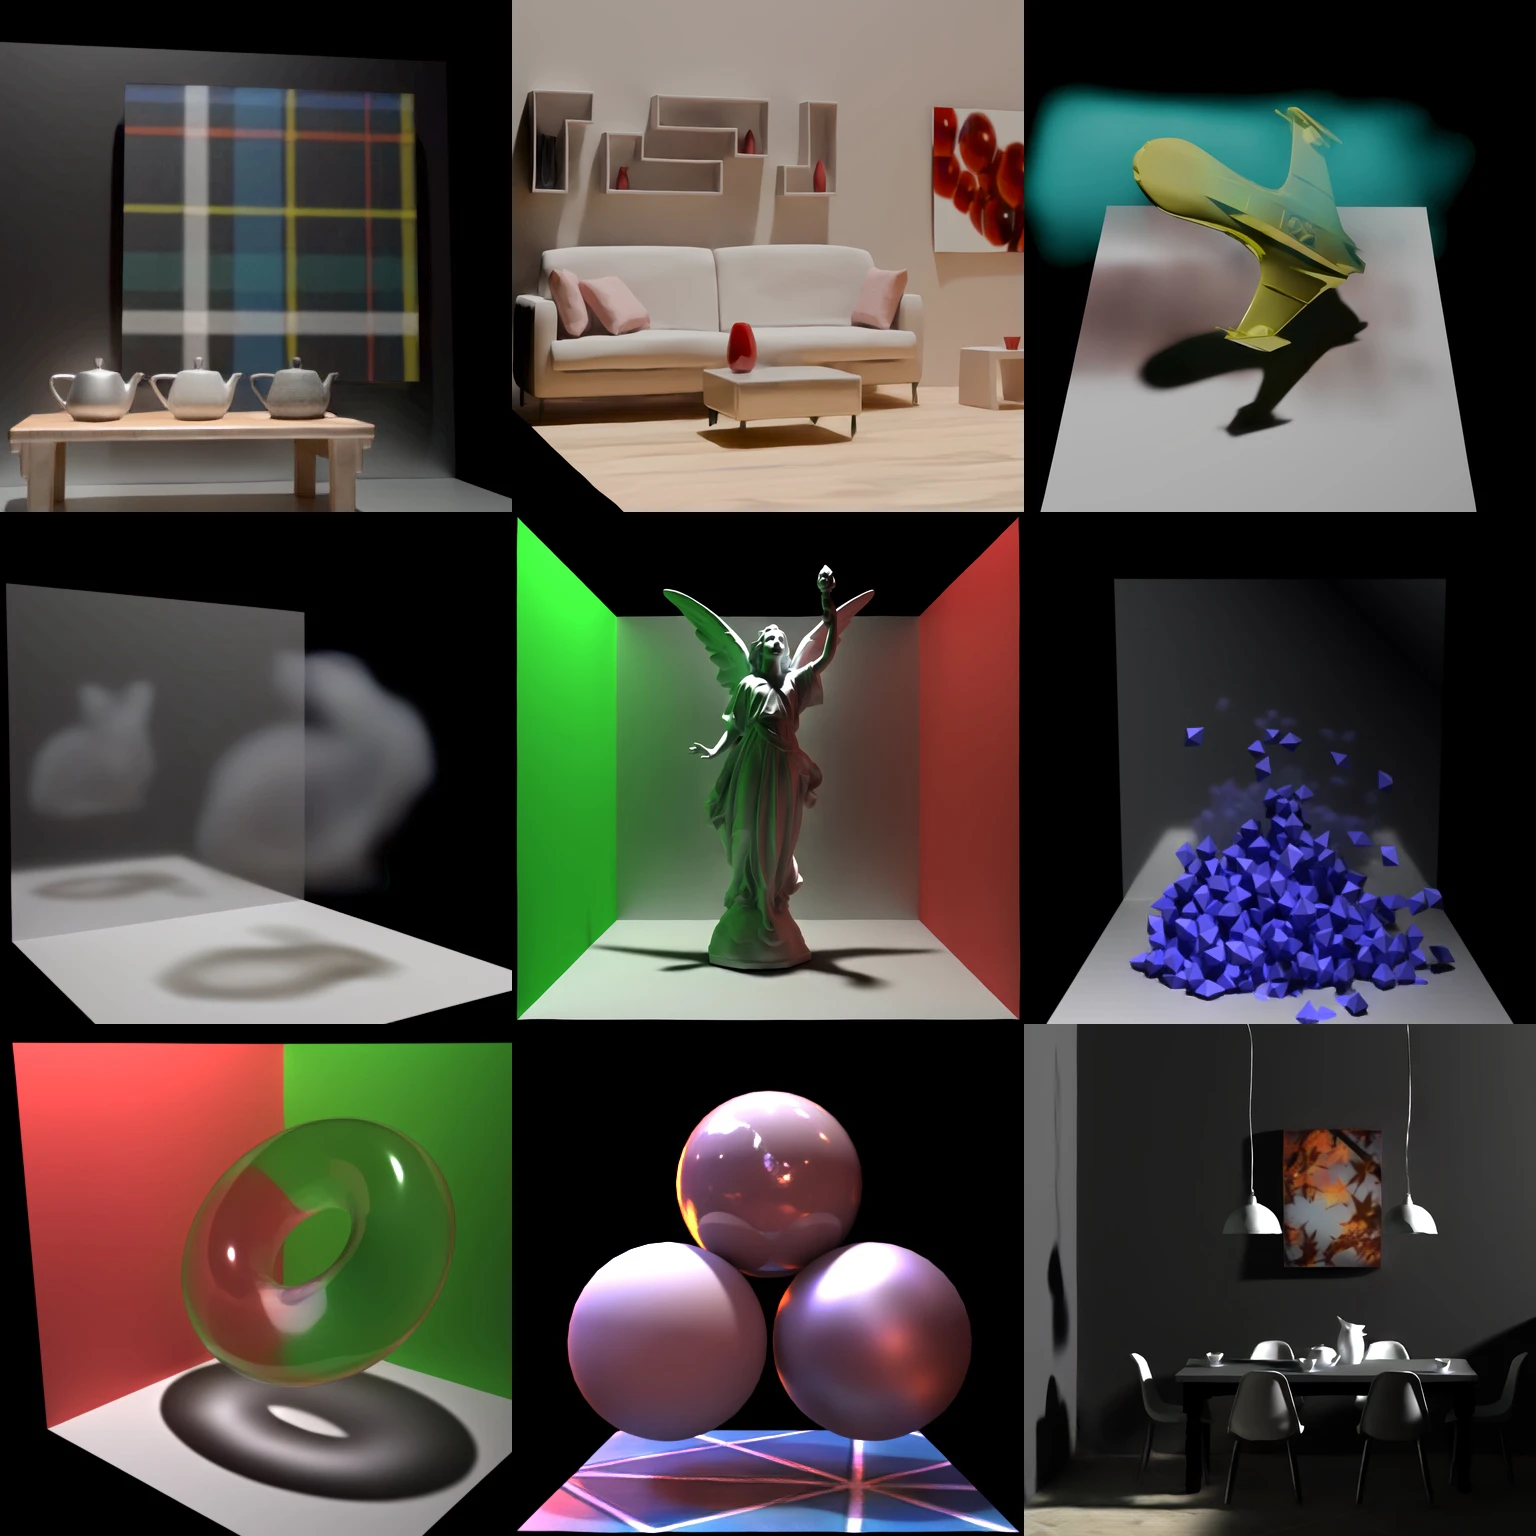
Stanford、Microsoft Research、William & MaryによるECCV 2026の研究です。幾何、材質、光源、カメラを入力し、同じ重みでさまざまなシーンを描画します。シーン別の学習は不要で、ネイティブ512・2048出力モデルがあります。
対応する光の表現
V2は屈折、環境照明、ボリューム散乱、テクスチャ、変位に対応します。ガラスは背景を変形させ、HDR環境はシーンを照らし、媒体は可視性と光輸送を変えます。
材質には固定GGXパラメータだけでなく学習した外観表現を使います。接触影、周囲の反射、ガラスの透過を見て効果を評価できます。
シーンデータからピクセルへ
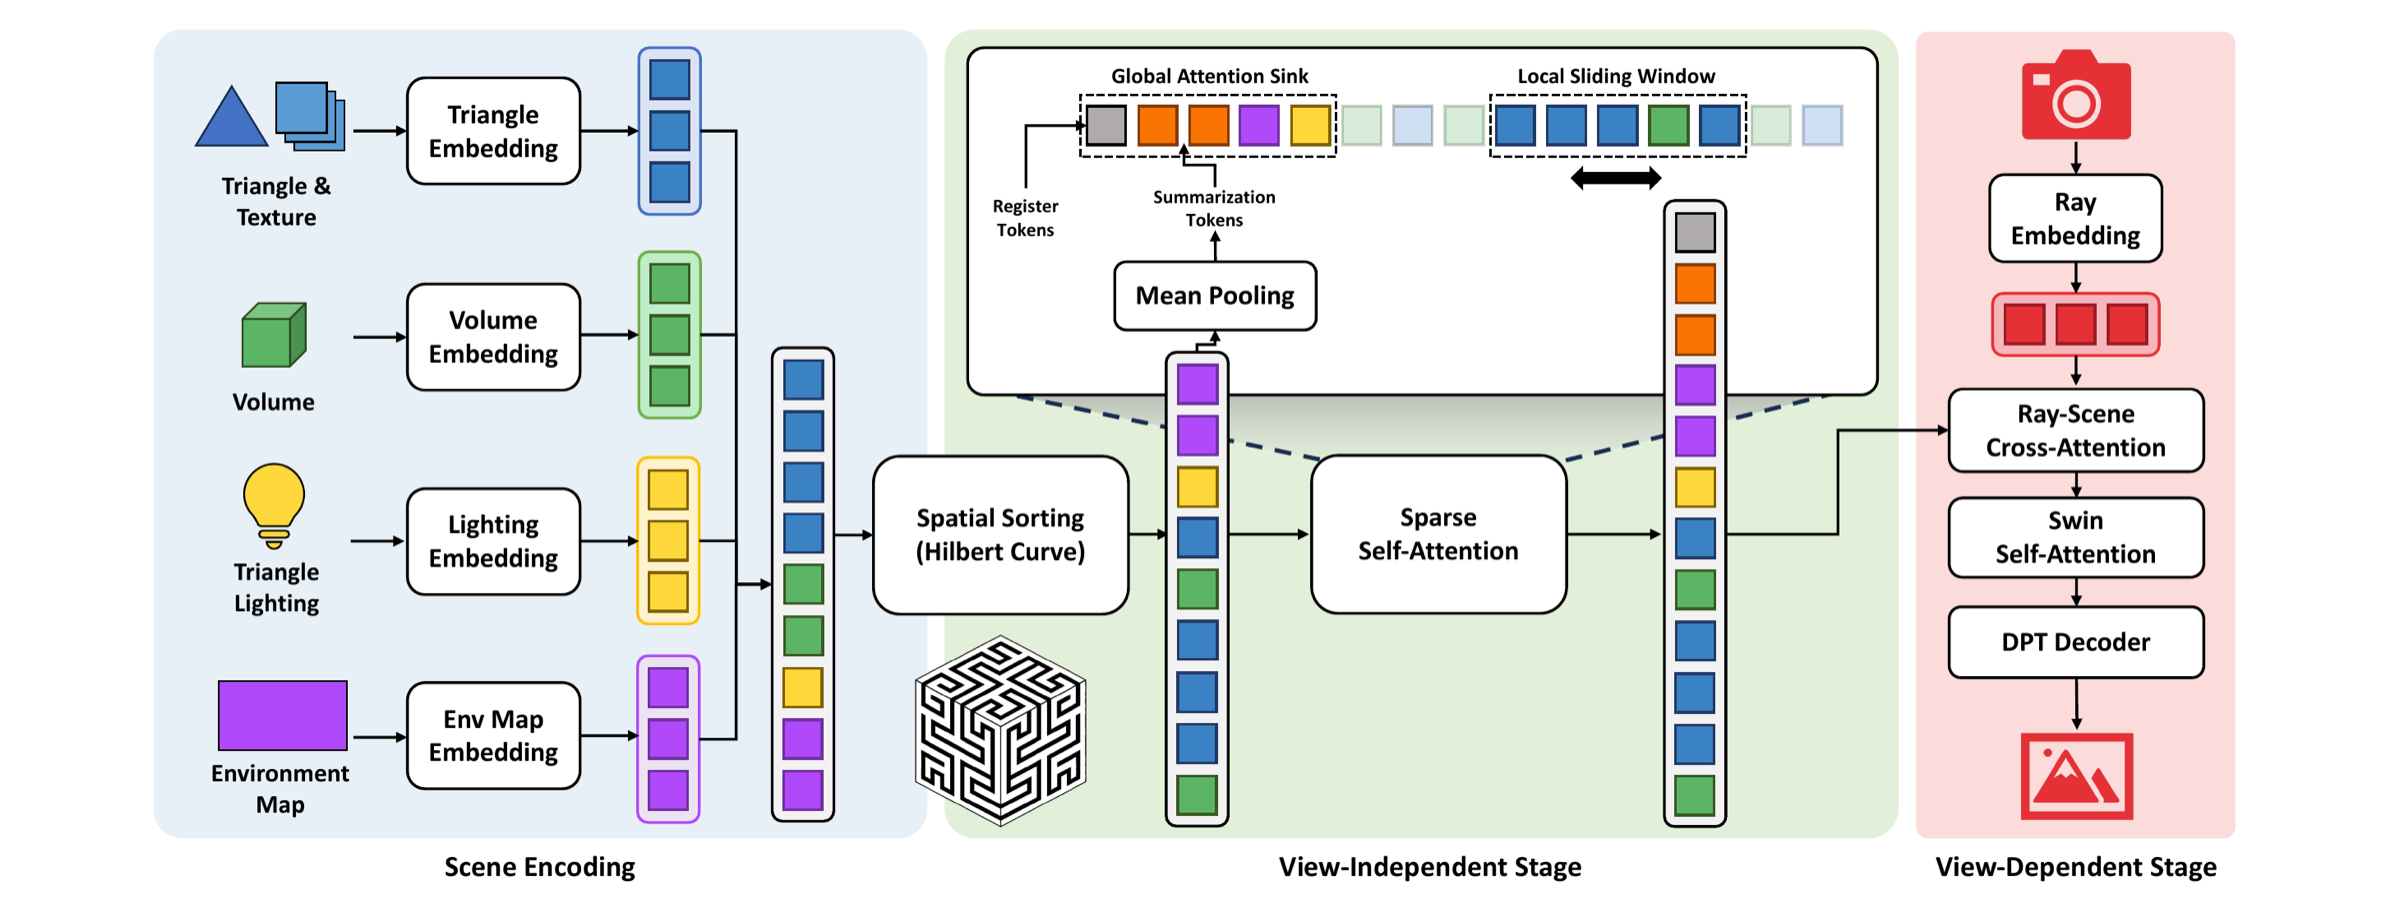
三角形、ボリューム、面光源、環境マップ、カメラ光線を同じトークン列にします。視点非依存段階で相互作用を処理し、視点依存段階でカメラ画像を作ります。
局所注意とグローバルな注意シンクにより128K超のプリミティブを扱います。V1は約4K三角形規模でした。ネットワーク内部で従来の光線追跡を実行するのではなく、光輸送を学習します。
シーンを準備して描画
RenderFormer Studio、Python 3.10または3.11、公式推論環境を使用し、RF2付属例から始めます。Blender V2拡張はprepared-frame中間データを出力し、データ工程で描画用の処理済みH5へ生成・変換します。
以下はtransformer_512のコマンドです。ネイティブ2048出力にはtransformer_2048と対応解像度を選びます。材質・テクスチャ関連部品も含むため、V1ローダーではなくV2パイプラインを使います。
renderformer infer \
  --input processed/scene.h5 \
  --checkpoint RenderFormer/renderformer-v2 \
  --checkpoint-subfolder transformer_512 \
  --precision fp16 \
  --output-dir outputs
3D制作で使う段階
V2はアセット生成とシーン構築の後に使います。物体をBlenderに配置し、材質と照明を設定してからデータを準備します。MoGe-3は写真から可視幾何を復元する前段階のツールです。
出力は入力シーンの画像であり、新しいメッシュではありません。V2は材質や照明を探索し、必要な物体がなければ画像から3Dを作る生成器を使います。
生成・復元・描画の違い
| ツール | 入力 → 出力 | 役割 |
|---|---|---|
| 画像から3D生成 | 参考画像 → アセット | 幾何と外観を生成 |
| MoGe-3 | 写真 → 深度・可視幾何 | 幾何を復元 |
| RenderFormer-V1 | 三角形シーン → 画像 | 小規模なニューラル描画 |
| RenderFormer-V2 | 混合プリミティブ → 画像 | 屈折・環境光・テクスチャ・媒体 |
よくある質問
GLBを推論コマンドへ直接入力できますか?
公式V2の入力は準備済みH5シーンです。GLBをBlenderに読み込み、シーンを設定してV2出力とデータ準備を行います。
シーンごとの学習は必要ですか?
不要です。同じ学習済み重みで異なるシーンを描画します。幾何、カメラ、照明を変えても個別の学習は必要ありません。
常にCyclesより高速ですか?
公式測定はNVIDIA A100と、ピクセル当たり4,096適応サンプルのCyclesを使用します。速度はシーン規模、解像度、ハードウェア、品質設定によって変わります。