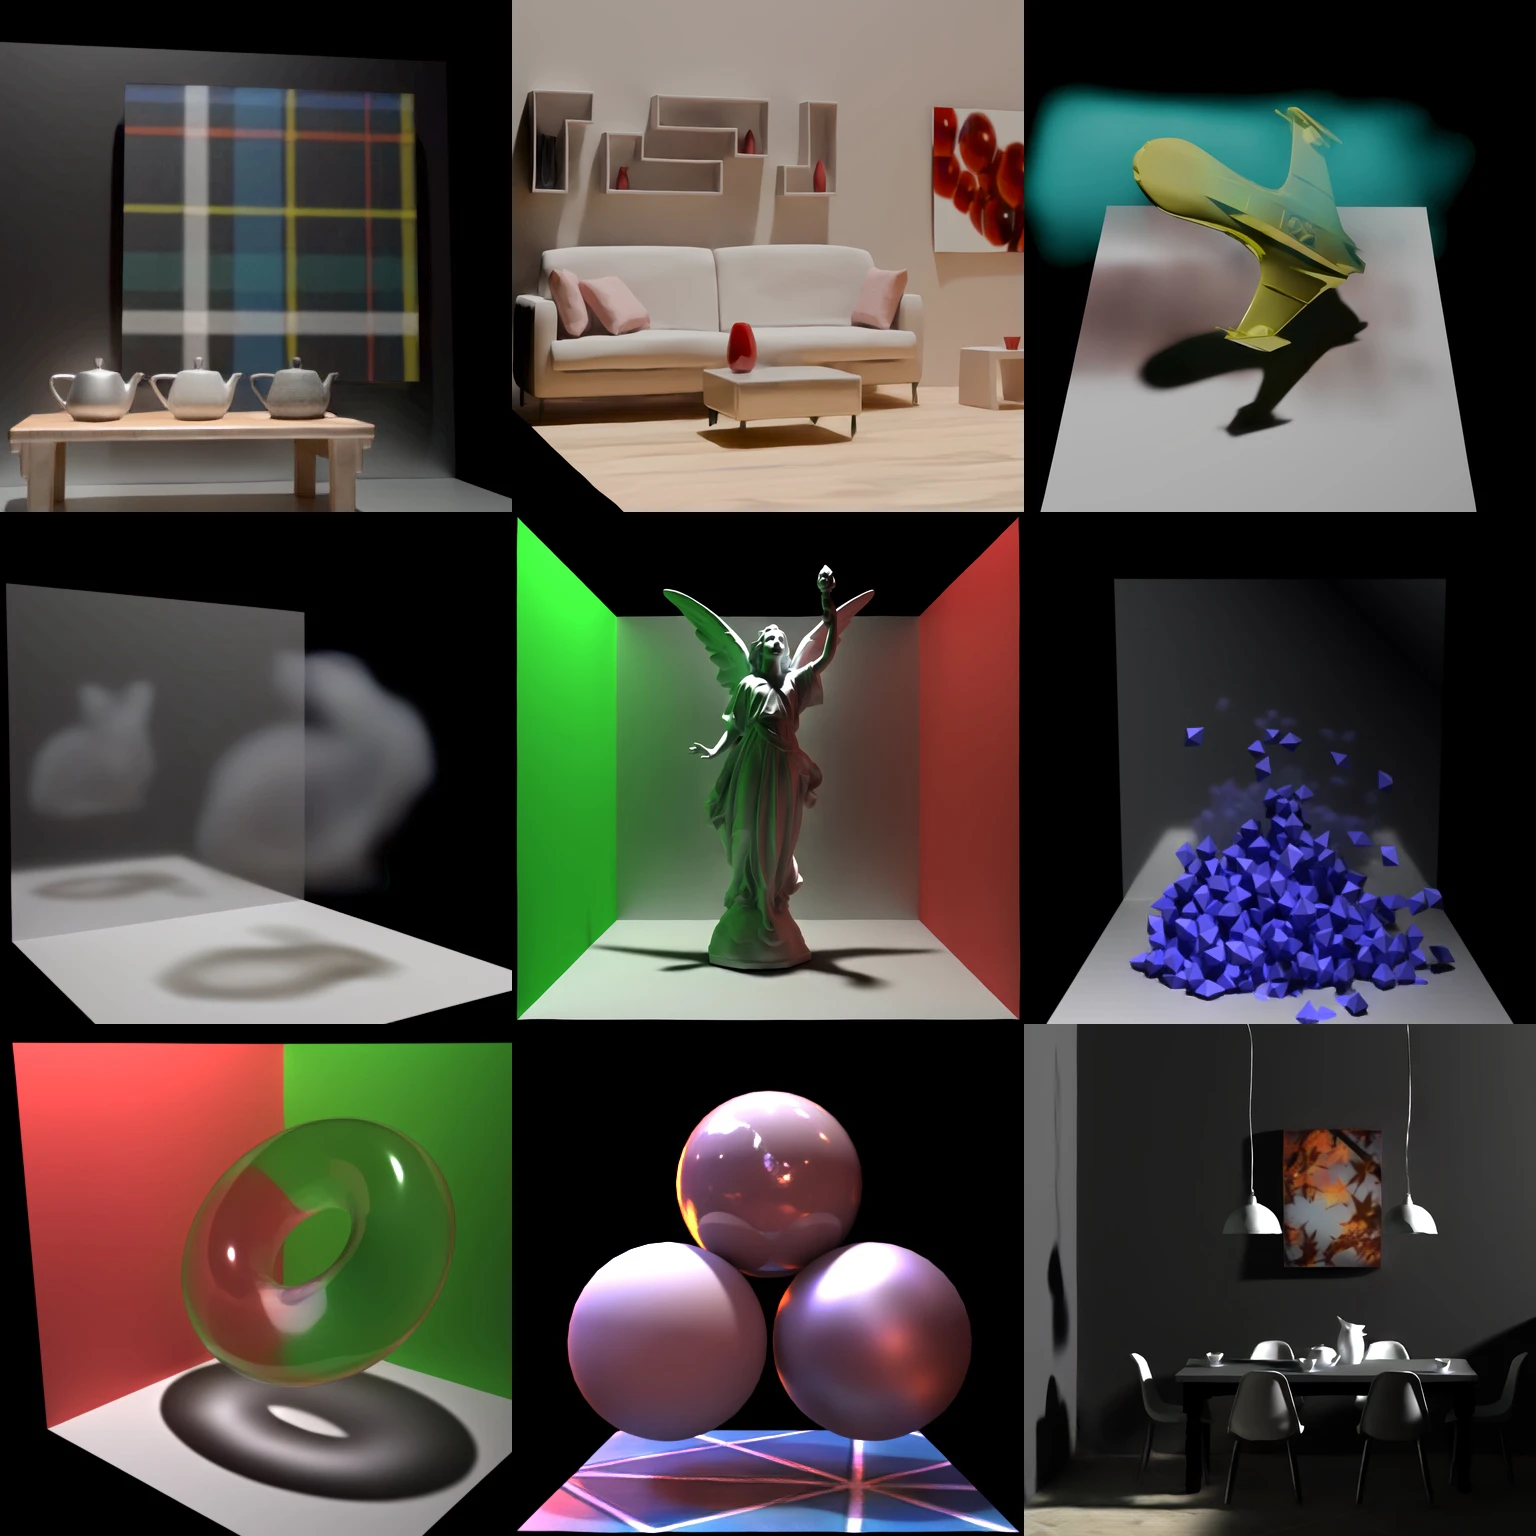
Das ECCV-2026-Projekt von Stanford, Microsoft Research und William & Mary verarbeitet Geometrie, Materialien, Licht und Kameras. Dieselben Gewichte rendern unterschiedliche Szenen ohne szenenspezifisches Training; native 512- und 2048-Modelle sind verfügbar.
Unterstützte Lichteffekte
V2 unterstützt Brechung, Umgebungslicht, Volumenstreuung, Texturen und Displacement. Glas verändert den Hintergrund, HDR-Umgebungen beleuchten die Szene und Volumen beeinflussen Sichtbarkeit und Lichttransport.
Materialien verwenden eine gelernte Erscheinungsdarstellung statt nur fester GGX-Parameter. Prüfe Kontaktschatten, Umgebungsreflexionen und Glasdurchlässigkeit, nicht nur Farben.
Von Szenendaten zu Pixeln
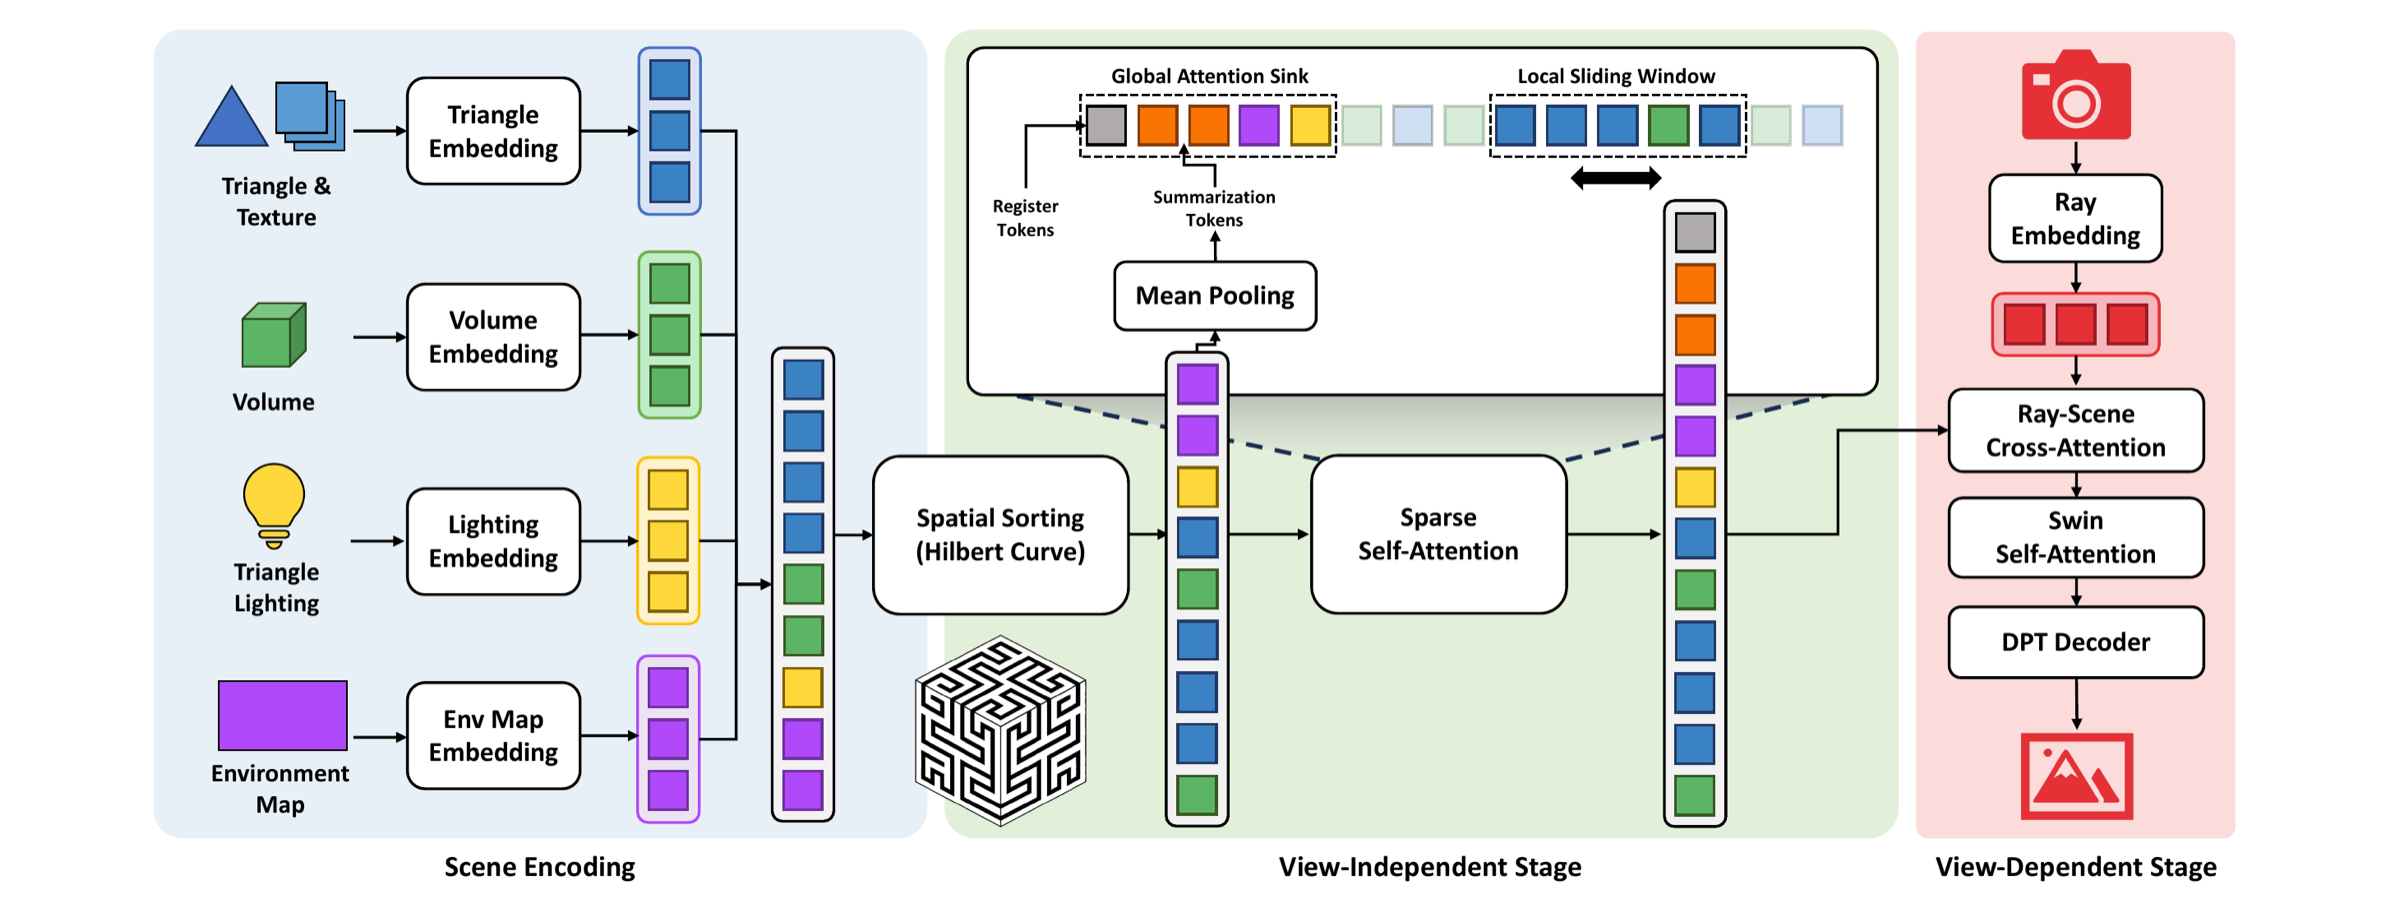
Dreiecke, Volumen, Flächenlichter, Umgebungskarten und Kamerastrahlen werden zu einer Tokenfolge. Erst werden ansichtsunabhängige Interaktionen modelliert, dann das Kamerabild erzeugt.
Lokale Attention und ein globaler Attention-Sink ermöglichen mehr als 128K Primitive gegenüber etwa 4K Dreiecken bei V1. Das Netz lernt Lichttransport, statt intern einen üblichen Raytracer auszuführen.
Szenen vorbereiten und rendern
Nutze RenderFormer Studio mit Python 3.10 oder 3.11 und der dokumentierten Inferenzumgebung. Beginne mit einem RF2-Beispiel. Die Blender-V2-Erweiterung exportiert prepared-frame-Zwischendaten, die anschließend zu verarbeitetem H5 generiert und konvertiert werden.
Der Befehl nutzt transformer_512. Für native 2048-Ausgabe wähle transformer_2048 mit passender Auflösung. Das Bundle enthält Material- und Texturkomponenten; verwende die V2-Pipeline statt eines V1-Loaders.
renderformer infer \
  --input processed/scene.h5 \
  --checkpoint RenderFormer/renderformer-v2 \
  --checkpoint-subfolder transformer_512 \
  --precision fp16 \
  --output-dir outputs
Einordnung in den 3D-Workflow
V2 folgt auf Asset-Erzeugung und Szenenaufbau. Platziere das Objekt in Blender, definiere Material und Licht und bereite die Daten vor. MoGe-3 rekonstruiert dagegen zunächst sichtbare Geometrie aus Fotos.
Ausgegeben wird ein Bild der vorhandenen Szene, kein neues Mesh. V2 dient zur Untersuchung von Material und Licht; ein Bild-zu-3D-Generator erstellt fehlende Objektassets.
Erzeugen, rekonstruieren oder rendern?
| Werkzeug | Eingabe → Ausgabe | Aufgabe |
|---|---|---|
| Bild-zu-3D-Generator | Vorlage → Objektasset | Geometrie und Erscheinung erzeugen |
| MoGe-3 | Foto → Tiefe und sichtbare Geometrie | Geometrie rekonstruieren |
| RenderFormer-V1 | Dreiecksszene → Bild | Neuronales Rendering kleinerer Szenen |
| RenderFormer-V2 | Gemischte Szenenprimitive → Bild | Brechung, Umgebung, Texturen und Volumen |
Häufige Fragen
Kann die Inferenz direkt GLB lesen?
Der dokumentierte V2-Eingang ist eine vorbereitete H5-Szene. Importiere GLB in Blender, richte die Szene ein und nutze den V2-Export samt Datenvorbereitung.
Muss jede Szene neu trainiert werden?
Nein. Dieselben vortrainierten Gewichte rendern verschiedene Szenen. Geometrie-, Kamera- oder Lichtänderungen benötigen kein separates Szenentraining.
Ist es immer schneller als Cycles?
Offizielle Messungen verwenden eine NVIDIA A100 und Cycles mit 4.096 adaptiven Samples pro Pixel. Szenengröße, Auflösung, Hardware und Qualitätsniveau beeinflussen die Geschwindigkeit.