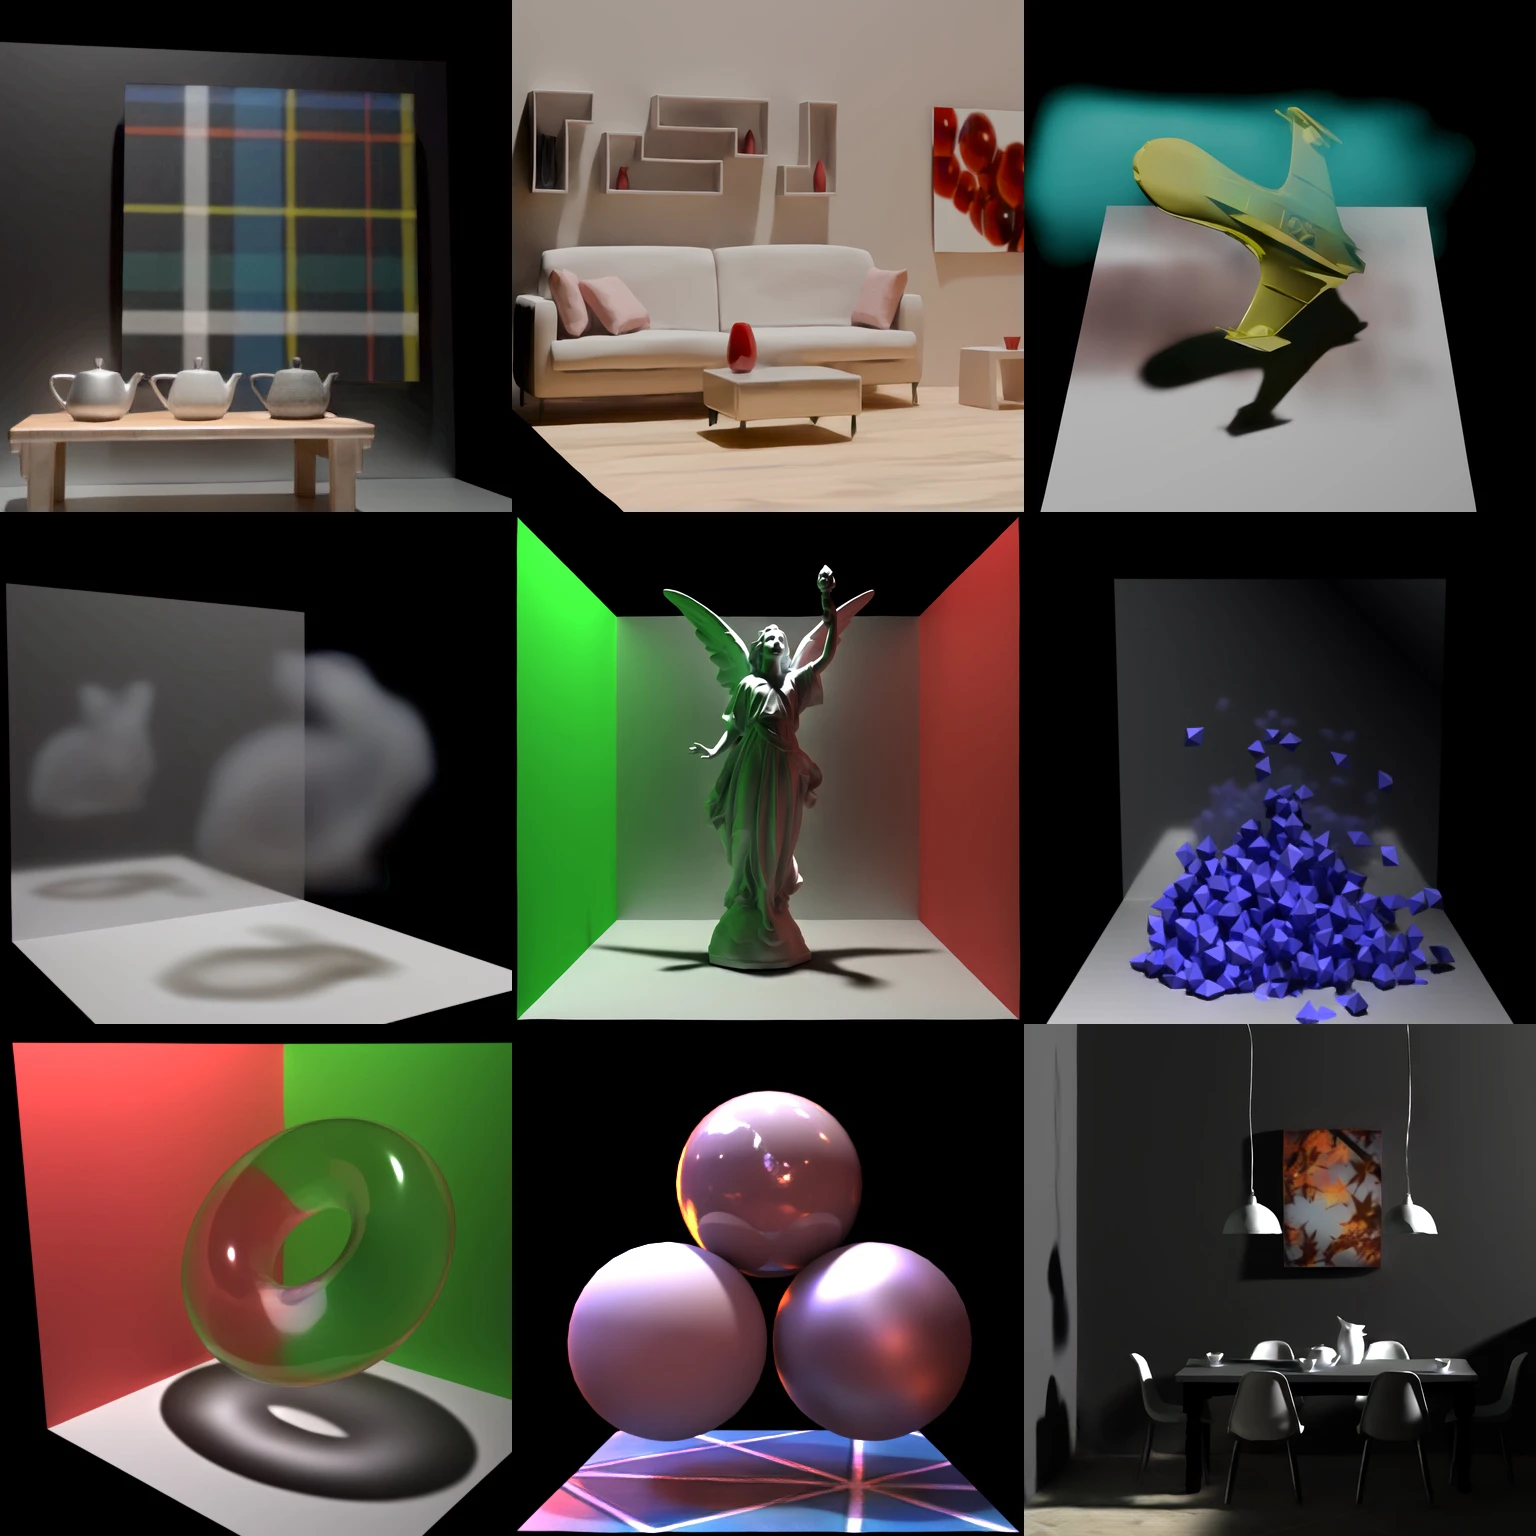
Projet ECCV 2026 de Stanford, Microsoft Research et William & Mary, V2 reçoit géométrie, matériaux, éclairage et caméras. Les mêmes poids servent à différentes scènes sans entraînement spécifique, avec des modèles natifs 512 et 2048.
Les effets de lumière pris en charge
V2 couvre réfraction, éclairage d’environnement, diffusion volumétrique, textures et déplacement. Le verre modifie l’arrière-plan, l’environnement HDR éclaire la scène et les volumes influencent visibilité et transport lumineux.
Les matériaux utilisent une représentation apprise de l’apparence plutôt que seulement des paramètres GGX fixes. Examinez ombres de contact, reflets de l’environnement et transmission du verre pour juger le résultat.
Des données de scène aux pixels
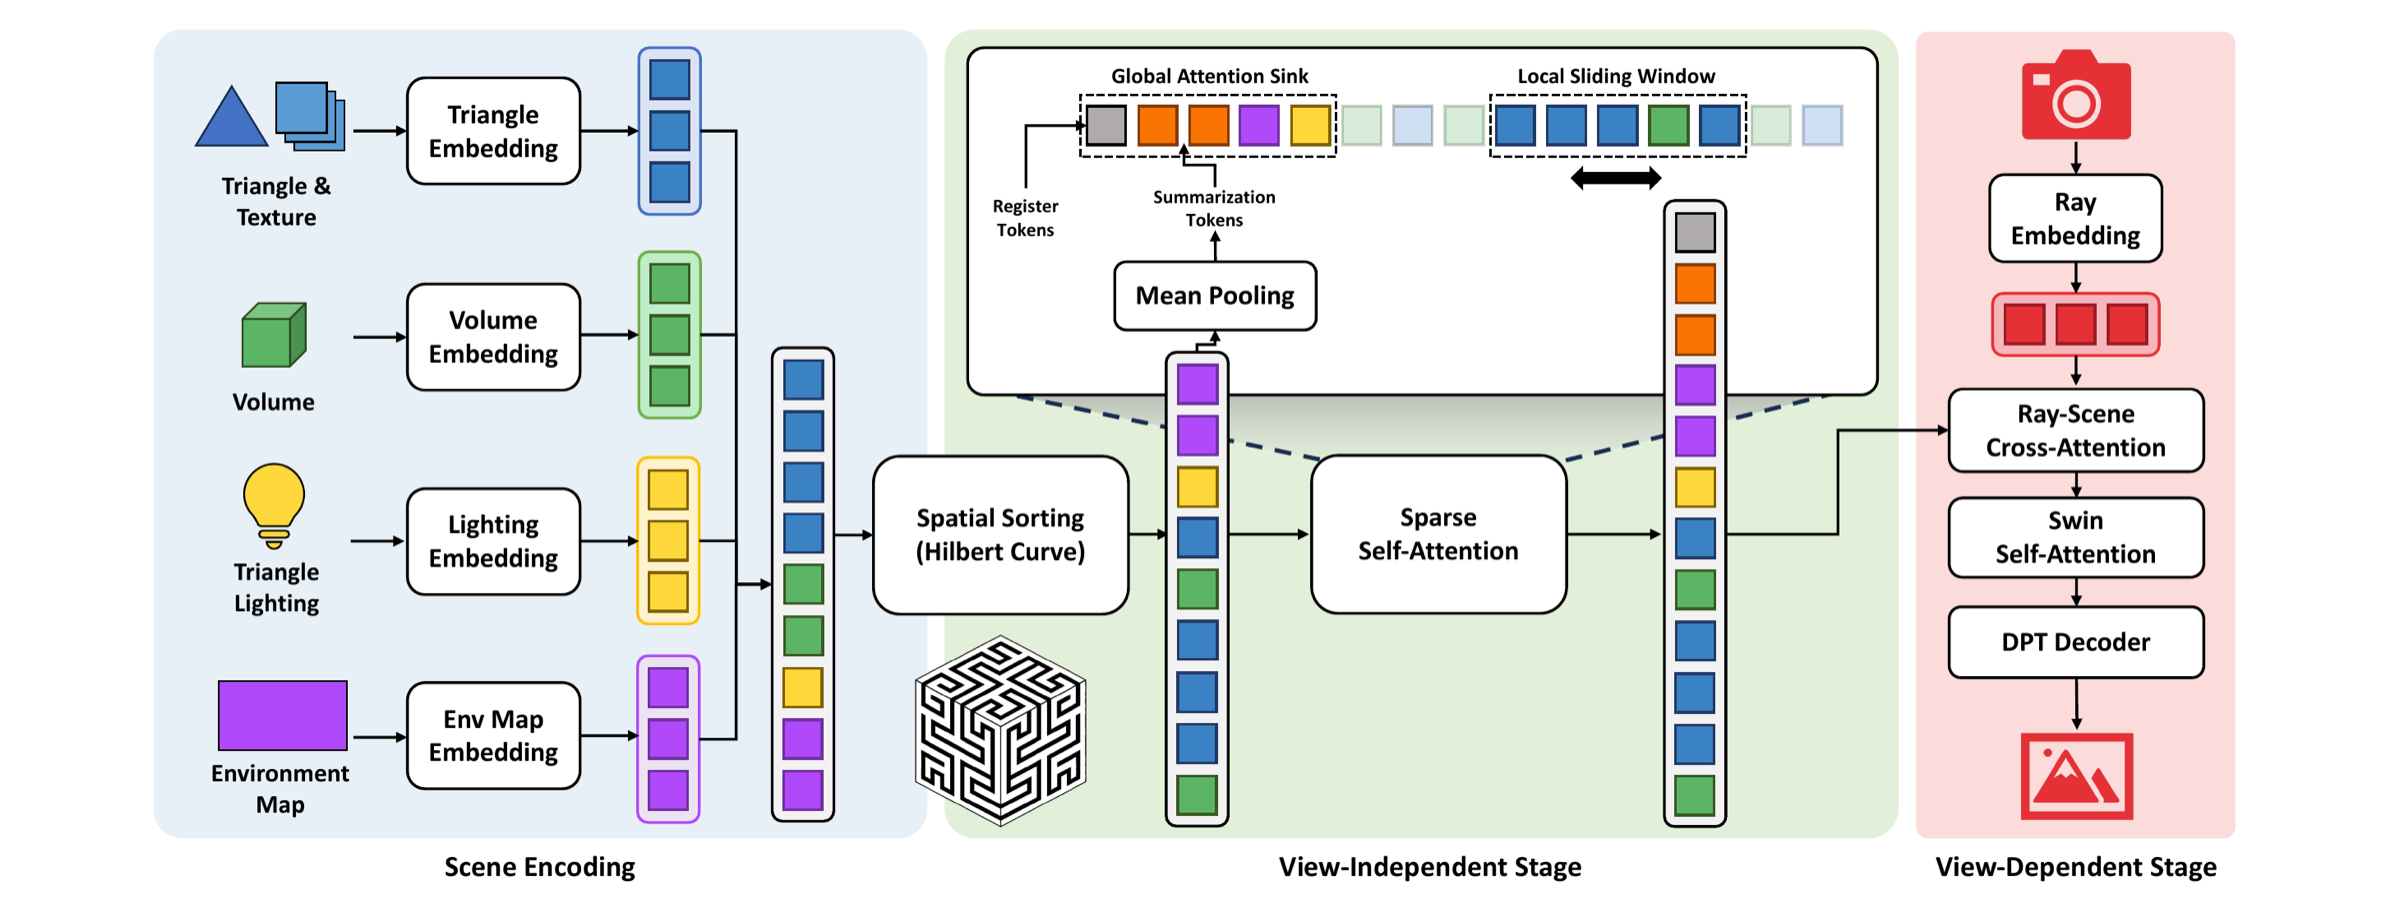
Triangles, volumes, sources surfaciques, cartes d’environnement et rayons de caméra sont encodés dans une même séquence. Une étape indépendante de la vue traite leurs interactions, puis une étape dépendante de la vue produit l’image.
L’attention locale et un réservoir global permettent de dépasser 128K primitives, contre environ 4K triangles pour V1. Le réseau apprend le transport lumineux au lieu d’exécuter un traceur de rayons conventionnel.
Préparer et rendre une scène
Utilisez RenderFormer Studio, Python 3.10 ou 3.11 et l’environnement d’inférence documenté. Commencez avec un exemple RF2. L’extension Blender V2 exporte un intermédiaire prepared-frame, ensuite généré et converti en H5 traité.
La commande utilise transformer_512. Pour le rendu natif 2048, choisissez transformer_2048 et la résolution correspondante. Le bundle inclut aussi les composants de matériaux et textures : utilisez le pipeline V2, pas le chargeur V1.
renderformer infer \
  --input processed/scene.h5 \
  --checkpoint RenderFormer/renderformer-v2 \
  --checkpoint-subfolder transformer_512 \
  --precision fp16 \
  --output-dir outputs
Sa place dans un workflow 3D
V2 intervient après création des assets et assemblage de la scène. Placez l’objet dans Blender, définissez matériaux et lumières, puis préparez les données. MoGe-3 récupère en amont la géométrie visible d’une photo.
La sortie est une image de la scène fournie, pas un nouveau maillage. Utilisez V2 pour explorer matériaux et lumière ; un générateur image-vers-3D crée l’objet manquant.
Générer, reconstruire ou rendre ?
| Outil | Entrée → sortie | Rôle |
|---|---|---|
| Générateur image-vers-3D | Référence → asset | Créer géométrie et apparence |
| MoGe-3 | Photo → profondeur et géométrie visible | Reconstruire la géométrie |
| RenderFormer-V1 | Scène triangulaire → image | Rendu neuronal à plus petite échelle |
| RenderFormer-V2 | Scène à primitives mixtes → image | Réfraction, environnement, textures et volumes |
Questions fréquentes
Peut-on donner directement un GLB à la commande ?
L’entrée V2 documentée est une scène H5 préparée. Importez le GLB dans Blender, configurez la scène, puis suivez l’export et la préparation V2.
Chaque scène nécessite-t-elle un entraînement ?
Non. Les poids préentraînés rendent différentes scènes. Modifier géométrie, caméras ou lumières ne demande pas d’entraîner un modèle par scène.
Est-il toujours plus rapide que Cycles ?
Les mesures officielles utilisent une NVIDIA A100 et Cycles à 4 096 échantillons adaptatifs par pixel. Taille de scène, résolution, matériel et qualité influencent la vitesse.