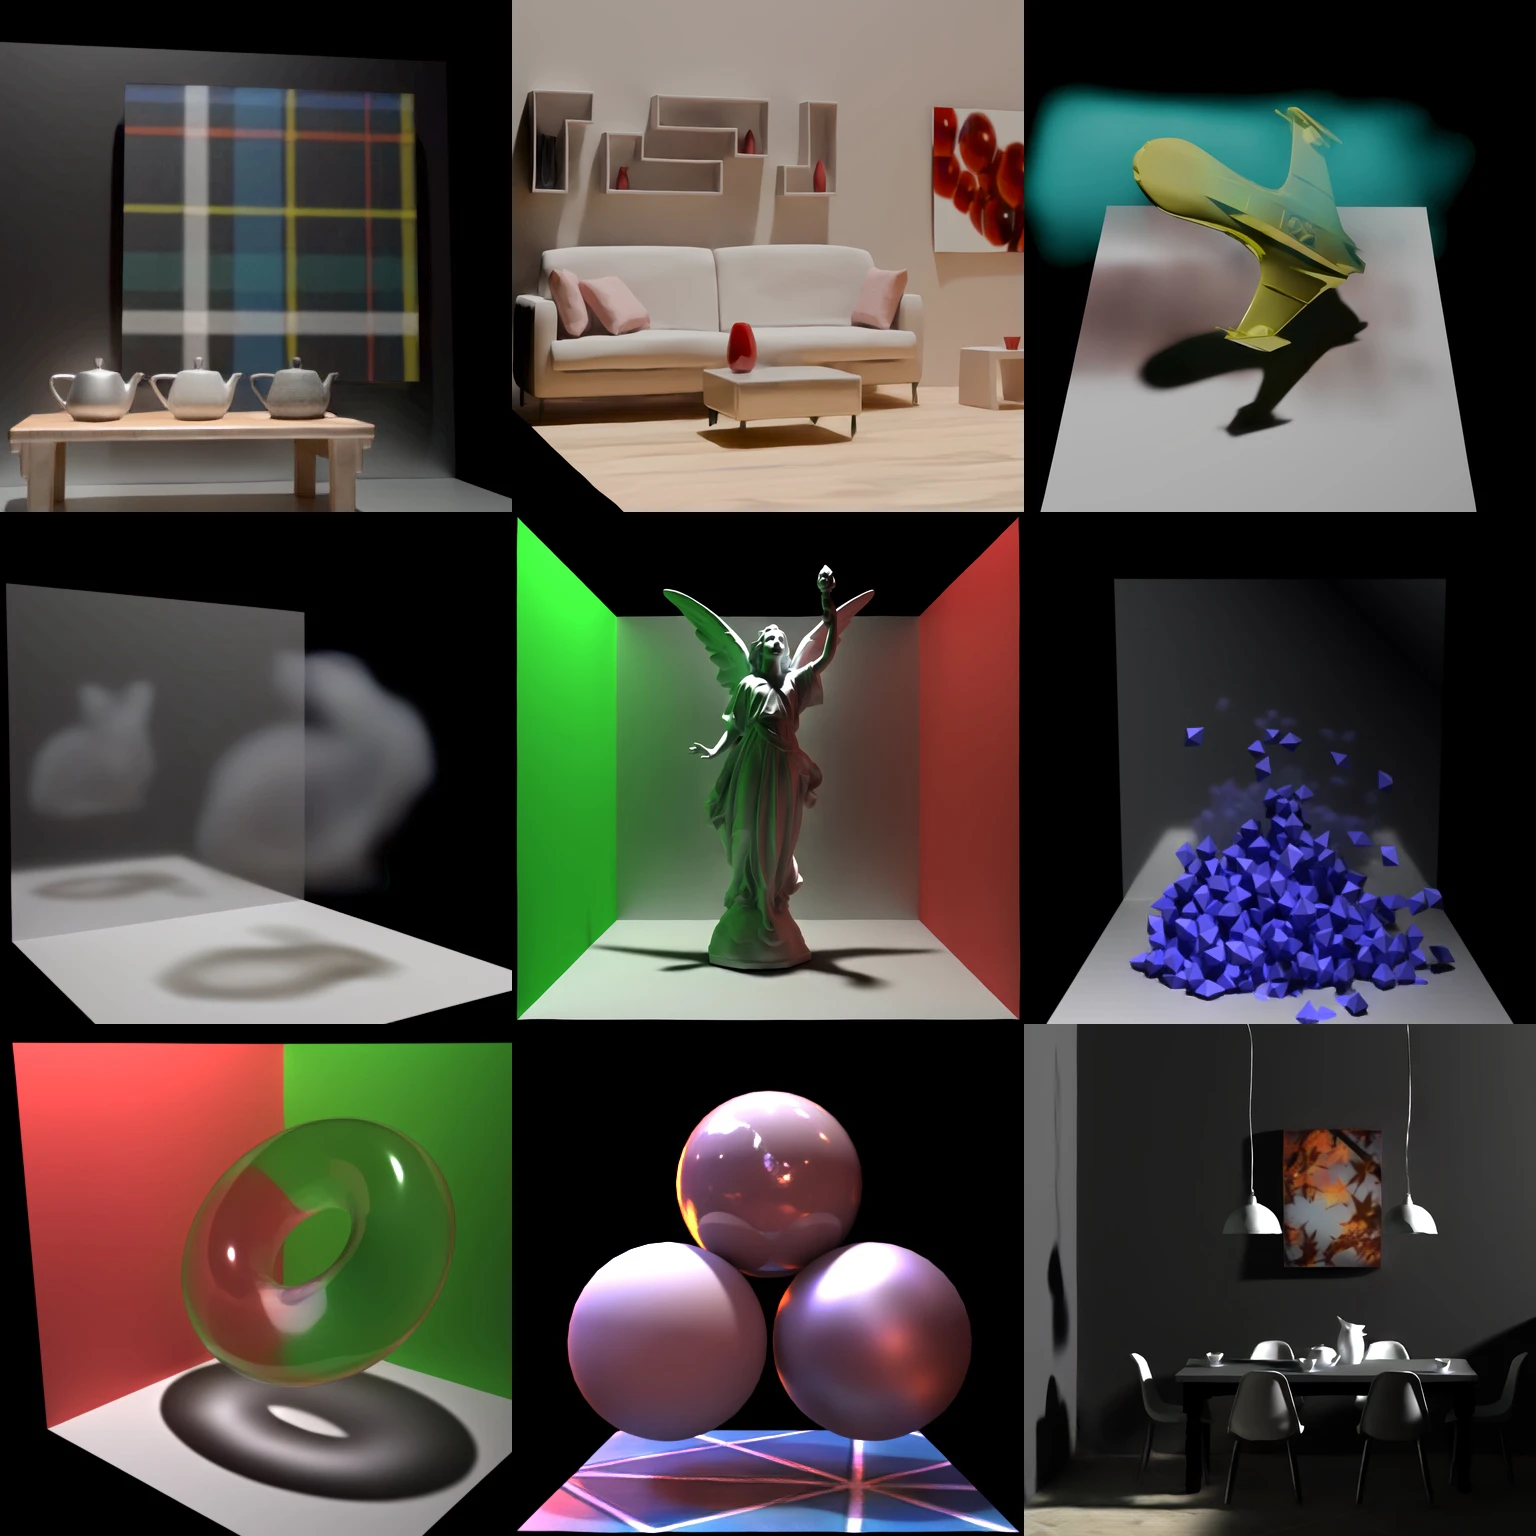
Projeto ECCV 2026 de Stanford, Microsoft Research e William & Mary, V2 recebe geometria, materiais, luzes e câmeras. Os mesmos pesos renderizam diferentes cenas sem treino específico, com modelos nativos de 512 e 2048.
Efeitos de luz disponíveis
V2 cobre refração, luz de ambiente, espalhamento volumétrico, texturas e deslocamento. O vidro altera o fundo, o ambiente HDR ilumina e os volumes afetam visibilidade e transporte de luz.
Os materiais usam uma representação aprendida de aparência, não apenas parâmetros GGX fixos. Confira sombras de contato, reflexos do ambiente e transmissão pelo vidro.
Dos dados de cena aos pixels
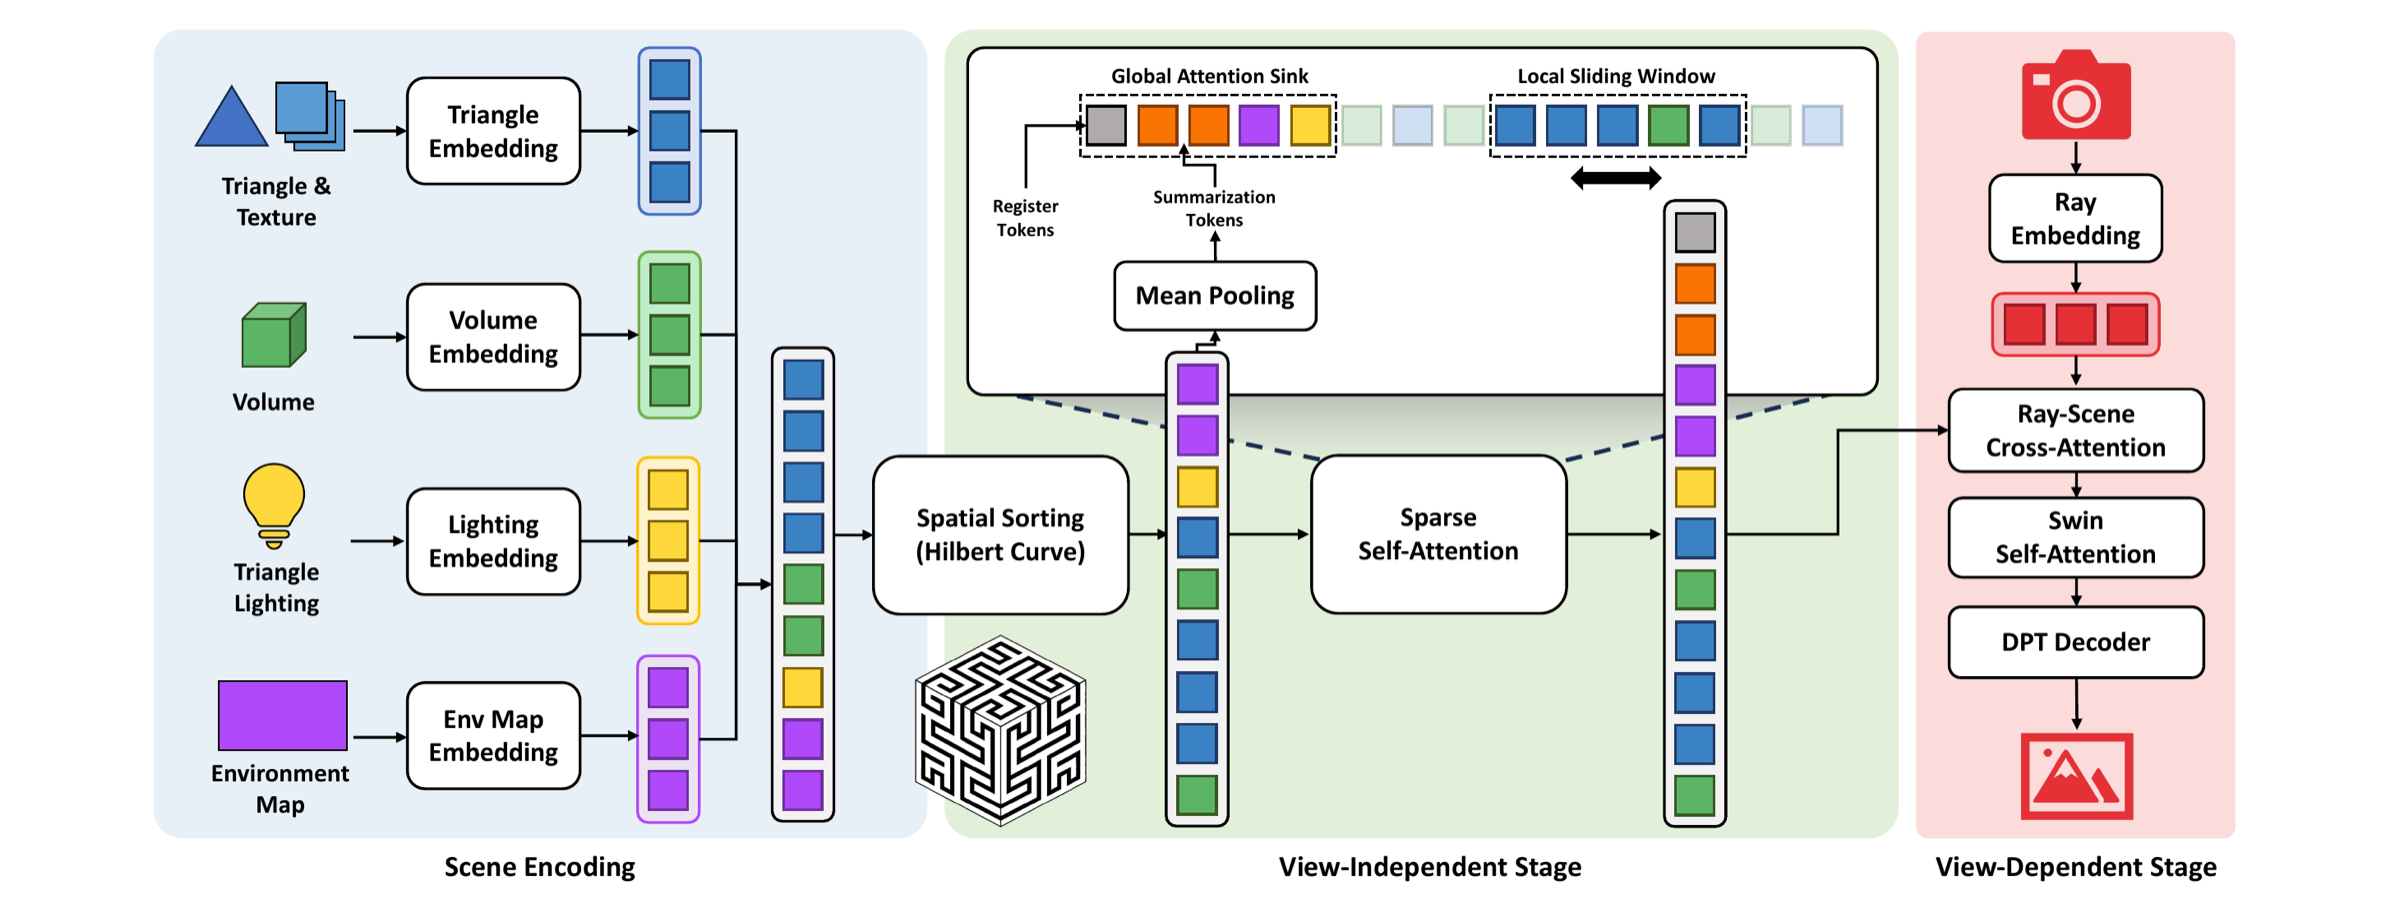
Triângulos, volumes, luzes de área, mapas de ambiente e raios de câmera formam uma sequência de tokens. Primeiro são modeladas interações independentes da vista, depois a imagem da câmera.
Atenção local e um sumidouro global permitem superar 128K primitivas, contra cerca de 4K triângulos no V1. A rede aprende transporte de luz em vez de executar um ray tracer convencional.
Preparar e renderizar uma cena
Use RenderFormer Studio com Python 3.10 ou 3.11 e o ambiente documentado. Comece por um exemplo RF2. A extensão Blender V2 exporta um intermediário prepared-frame, que o pipeline de dados gera e converte para H5 processado.
O comando usa transformer_512. Para saída nativa 2048, escolha transformer_2048 e a resolução correspondente. O pacote inclui componentes de materiais e texturas: utilize o pipeline V2, não um carregador V1.
renderformer infer \
  --input processed/scene.h5 \
  --checkpoint RenderFormer/renderformer-v2 \
  --checkpoint-subfolder transformer_512 \
  --precision fp16 \
  --output-dir outputs
Seu lugar no fluxo 3D
V2 vem depois da criação dos assets e montagem da cena. Coloque o objeto no Blender, configure materiais e luzes e prepare os dados. MoGe-3 recupera antes a geometria visível de uma foto.
A saída é uma imagem da cena fornecida, não uma nova malha. V2 explora materiais e luz; um gerador de imagem para 3D cria o objeto que falta.
Geração, reconstrução ou renderização?
| Ferramenta | Entrada → saída | Função |
|---|---|---|
| Gerador de imagem para 3D | Referência → asset | Criar geometria e aparência |
| MoGe-3 | Foto → profundidade e geometria visível | Recuperar geometria |
| RenderFormer-V1 | Cena de triângulos → imagem | Renderização neural em menor escala |
| RenderFormer-V2 | Cena de primitivas mistas → imagem | Refração, ambiente, texturas e volumes |
Perguntas frequentes
Posso passar um GLB direto para a inferência?
A entrada V2 documentada é uma cena H5 preparada. Importe GLB no Blender, configure a cena e siga a exportação e preparação V2.
Cada cena precisa de treinamento?
Não. Os mesmos pesos pré-treinados renderizam cenas diferentes. Alterar geometria, câmeras ou luzes não exige treino por cena.
É sempre mais rápido que Cycles?
As medições oficiais usam NVIDIA A100 e Cycles com 4.096 amostras adaptativas por pixel. A velocidade depende da cena, resolução, hardware e qualidade.