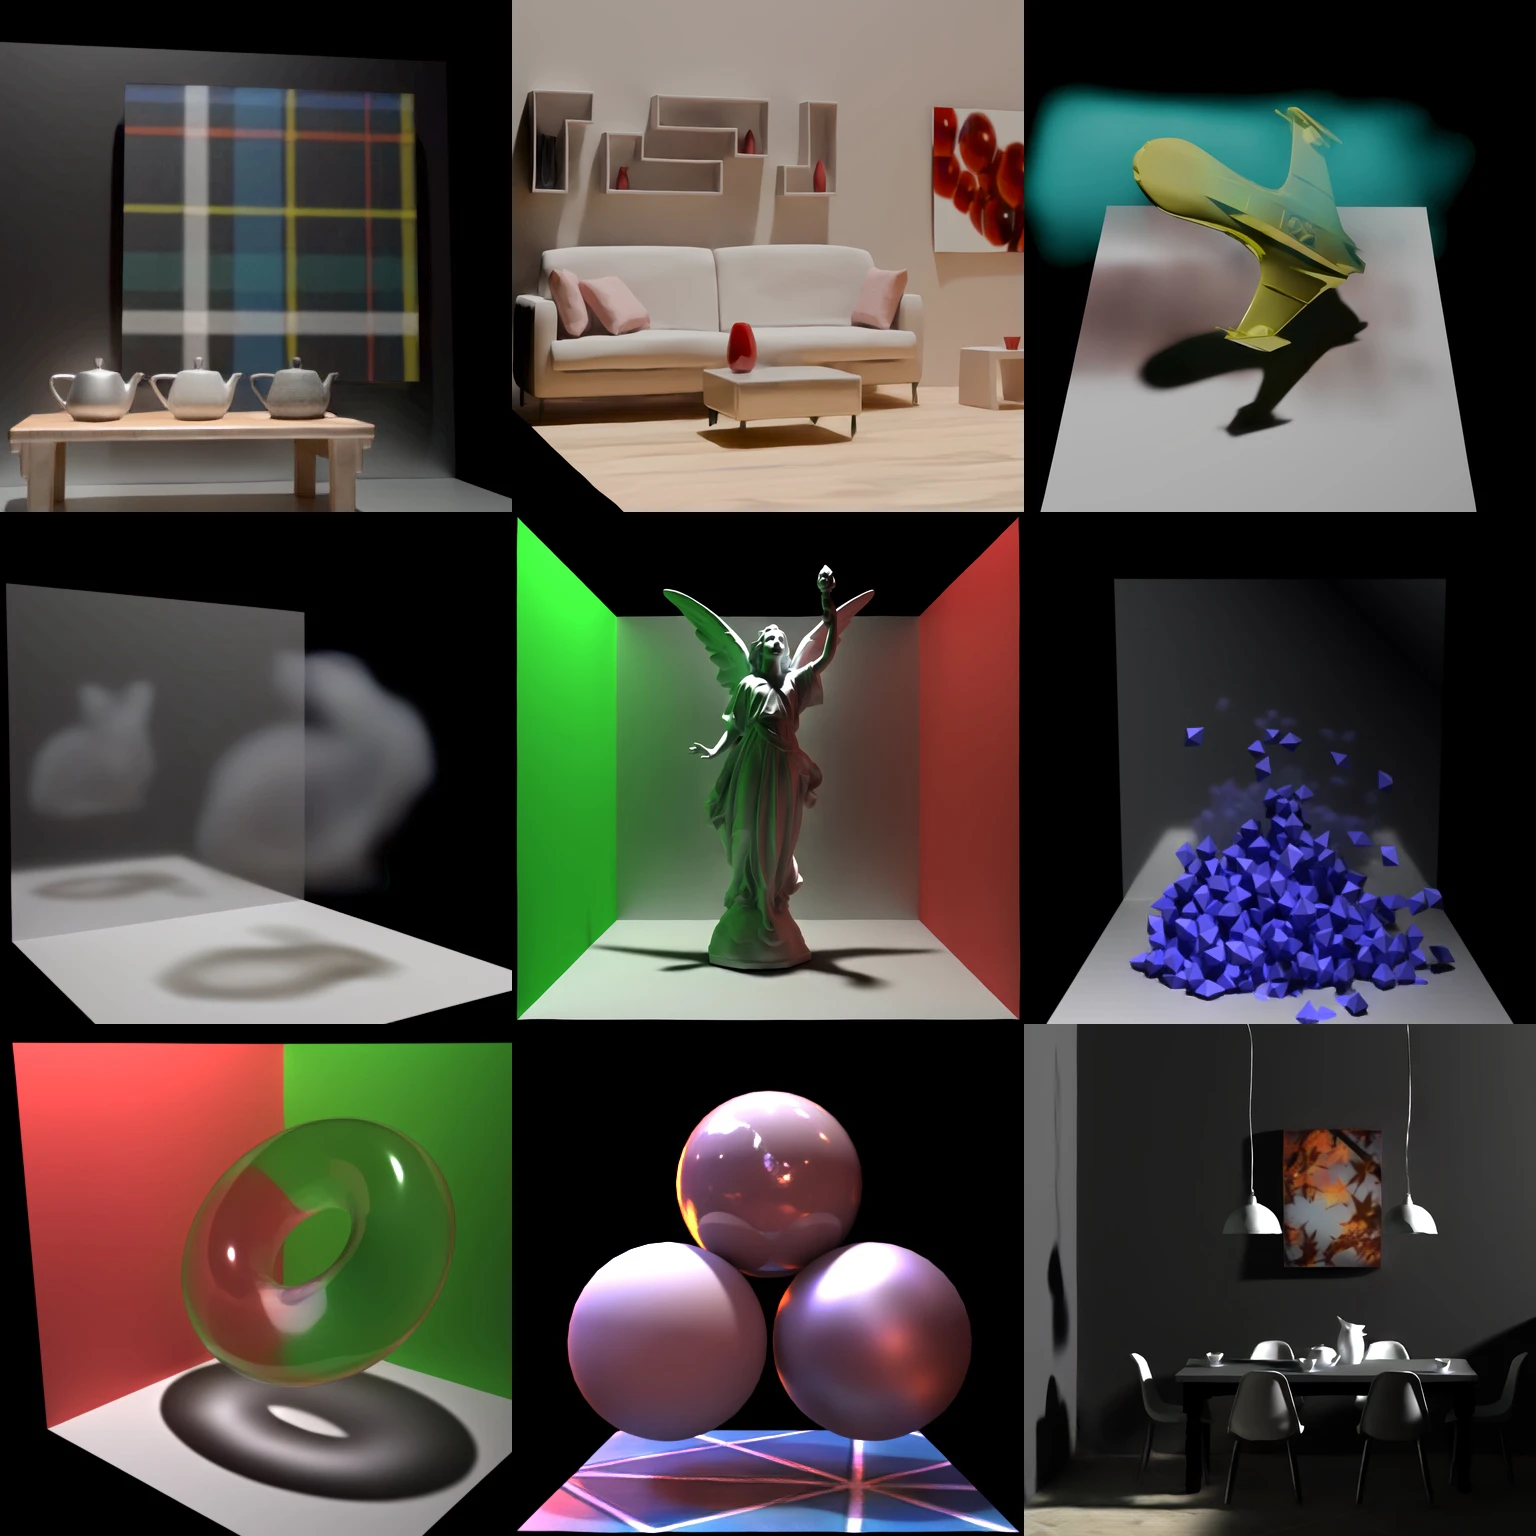
RenderFormer-V2 是斯坦福大学、微软研究院与威廉与玛丽学院的 ECCV 2026 项目,输入几何、材质、灯光与相机。同一套权重可渲染不同场景,无需逐场景训练,已发布原生 512 和 2048 输出模型。
渲染效果有哪些变化
V2 支持折射、环境光、体积散射、纹理表面和置换。透明物体会改变背景的观感,HDR 环境可以照亮场景,体积介质则影响可见性与光传输。
材质使用学习得到的外观表示,不只依赖固定的 GGX 参数。检查效果时,可以重点看接触阴影、环境反射和玻璃透射,而不只是颜色是否相近。
从场景数据到图像
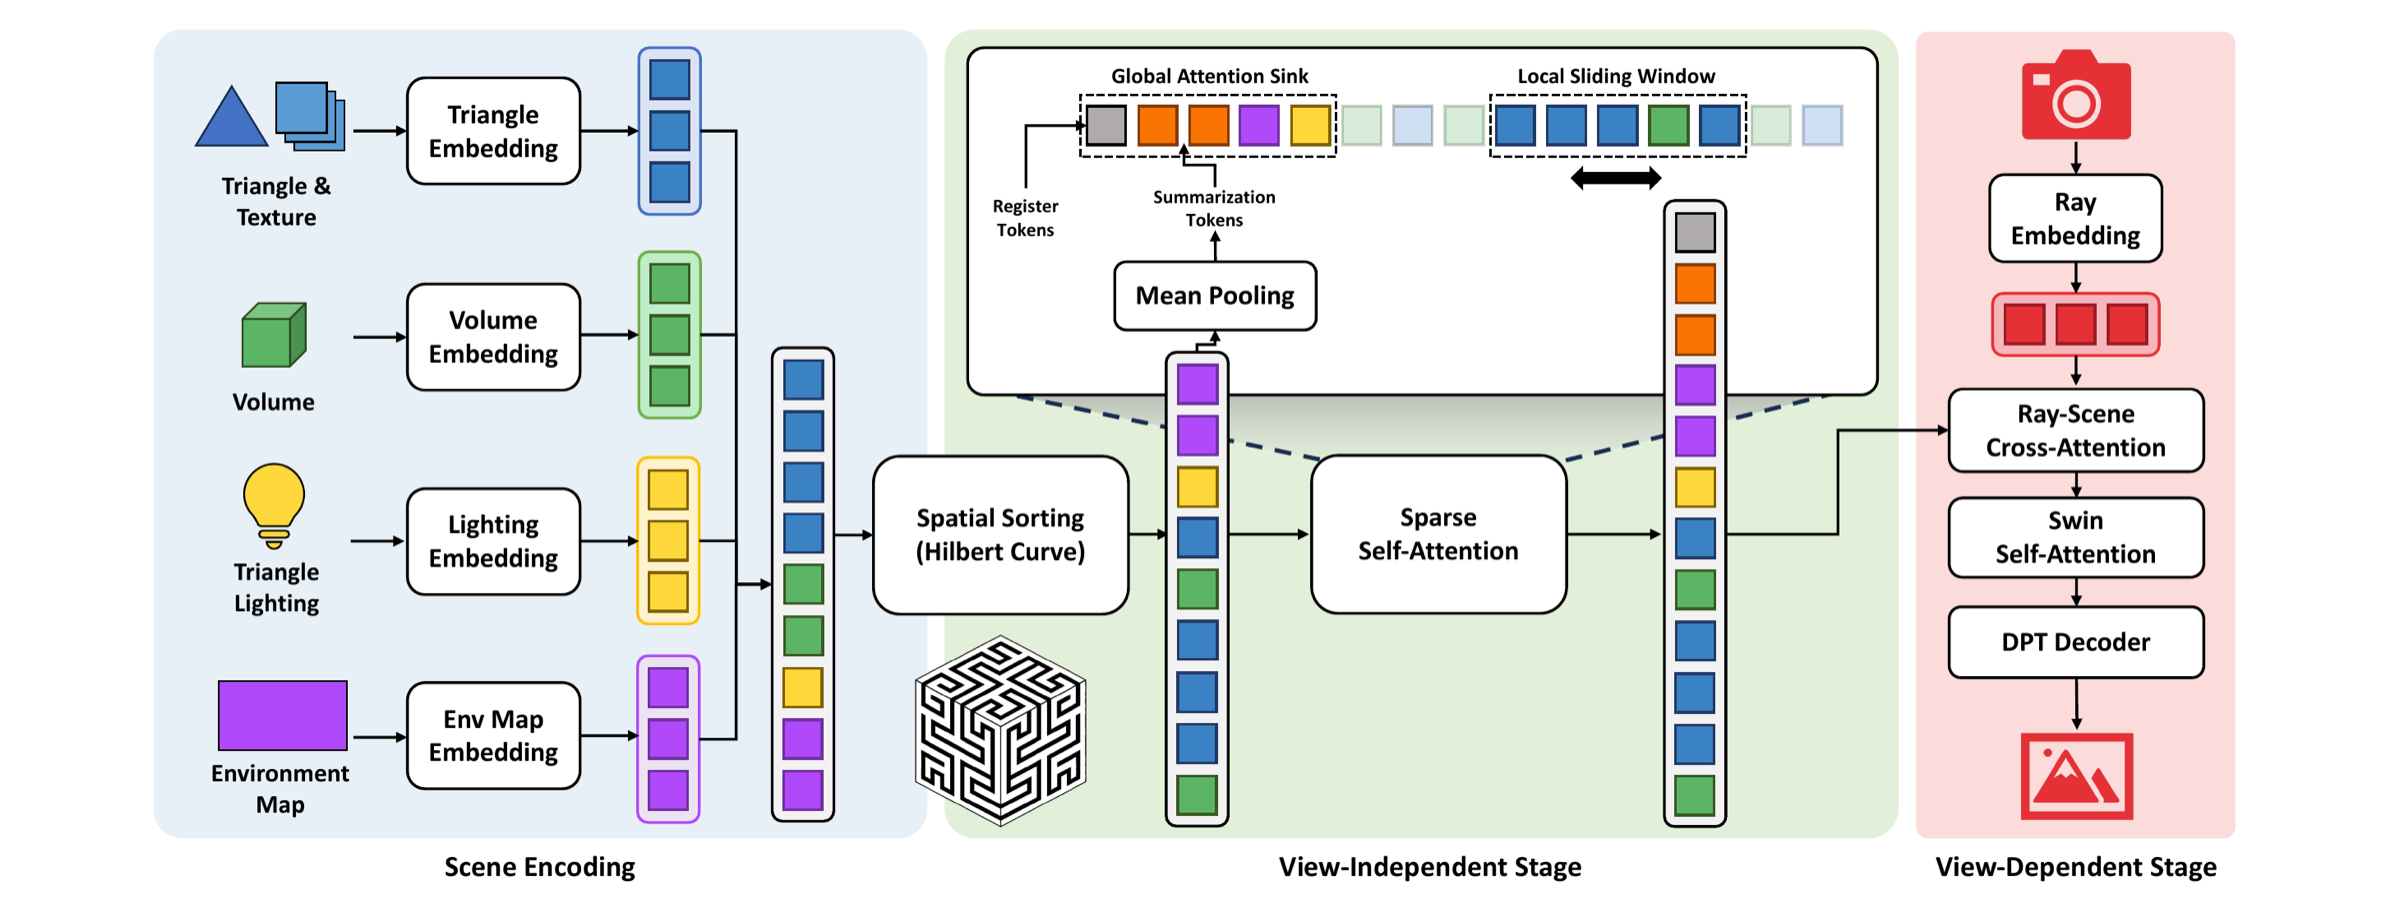
三角形、体积、面光源、环境贴图和相机射线被编码为同一序列的 token。第一阶段处理与视角无关的场景要素交互,第二阶段再输出指定相机的图像。
窗口注意力与全局注意力汇聚机制让 V2 能处理超过 128K 图元的场景,V1 的展示规模则约为 4K 三角形。网络学习的是光传输,而不是在内部执行传统光线追踪。
准备场景并运行渲染
使用 RenderFormer Studio、Python 3.10 或 3.11 和官方推理环境,先从自带 RF2 示例开始。自己的 Blender 场景可以用 V2 扩展导出 prepared-frame 中间数据,再经数据流程生成和转换为渲染所需的 processed H5。
下方命令用 transformer_512 渲染准备好的场景。原生 2048 输出要选择 transformer_2048 并匹配分辨率。模型包还包含材质和纹理相关组件,应使用 V2 流程,不能直接套用 V1 加载方式。
renderformer infer \
  --input processed/scene.h5 \
  --checkpoint RenderFormer/renderformer-v2 \
  --checkpoint-subfolder transformer_512 \
  --precision fp16 \
  --output-dir outputs
放到 3D 工作流的哪一步
RenderFormer-V2 位于资产生成和场景搭建之后。生成的物体可以先放进 Blender,配置材质、灯光,再准备渲染数据。MoGe-3 则处理更早的一步:从照片恢复可见几何。
输出是所提供场景的渲染图像,不是新生成的网格。可以用它探索材质与光照的神经渲染;缺少物体资产时,则先使用图片转 3D 工具。
生成、重建与渲染分别做什么
| 工具 | 输入 → 输出 | 主要用途 |
|---|---|---|
| 图片转 3D 生成器 | 参考图 → 物体资产 | 创建几何与外观 |
| MoGe-3 | 照片 → 深度、点云与可见几何 | 恢复场景几何 |
| RenderFormer-V1 | 三角形场景 → 渲染图像 | 较小规模的神经渲染 |
| RenderFormer-V2 | 混合图元场景 → 渲染图像 | 折射、环境光、纹理与体积效果 |
常见问题
能直接把 GLB 交给推理命令吗?
官方 V2 推理输入是准备好的 H5 场景,不是单独的 GLB。先把资产导入 Blender、配置场景,再按 V2 导出和数据准备流程处理。
每个场景都要重新训练吗?
不需要。发布的预训练模型用同一套权重渲染不同场景;调整几何、相机或灯光,无需为该场景单独训练。
一定比 Blender Cycles 快吗?
官方计时使用 NVIDIA A100,Cycles 设置为每像素 4,096 个自适应采样。速度还受场景规模、分辨率、硬件与质量设置影响,比较时需要对应这些条件。