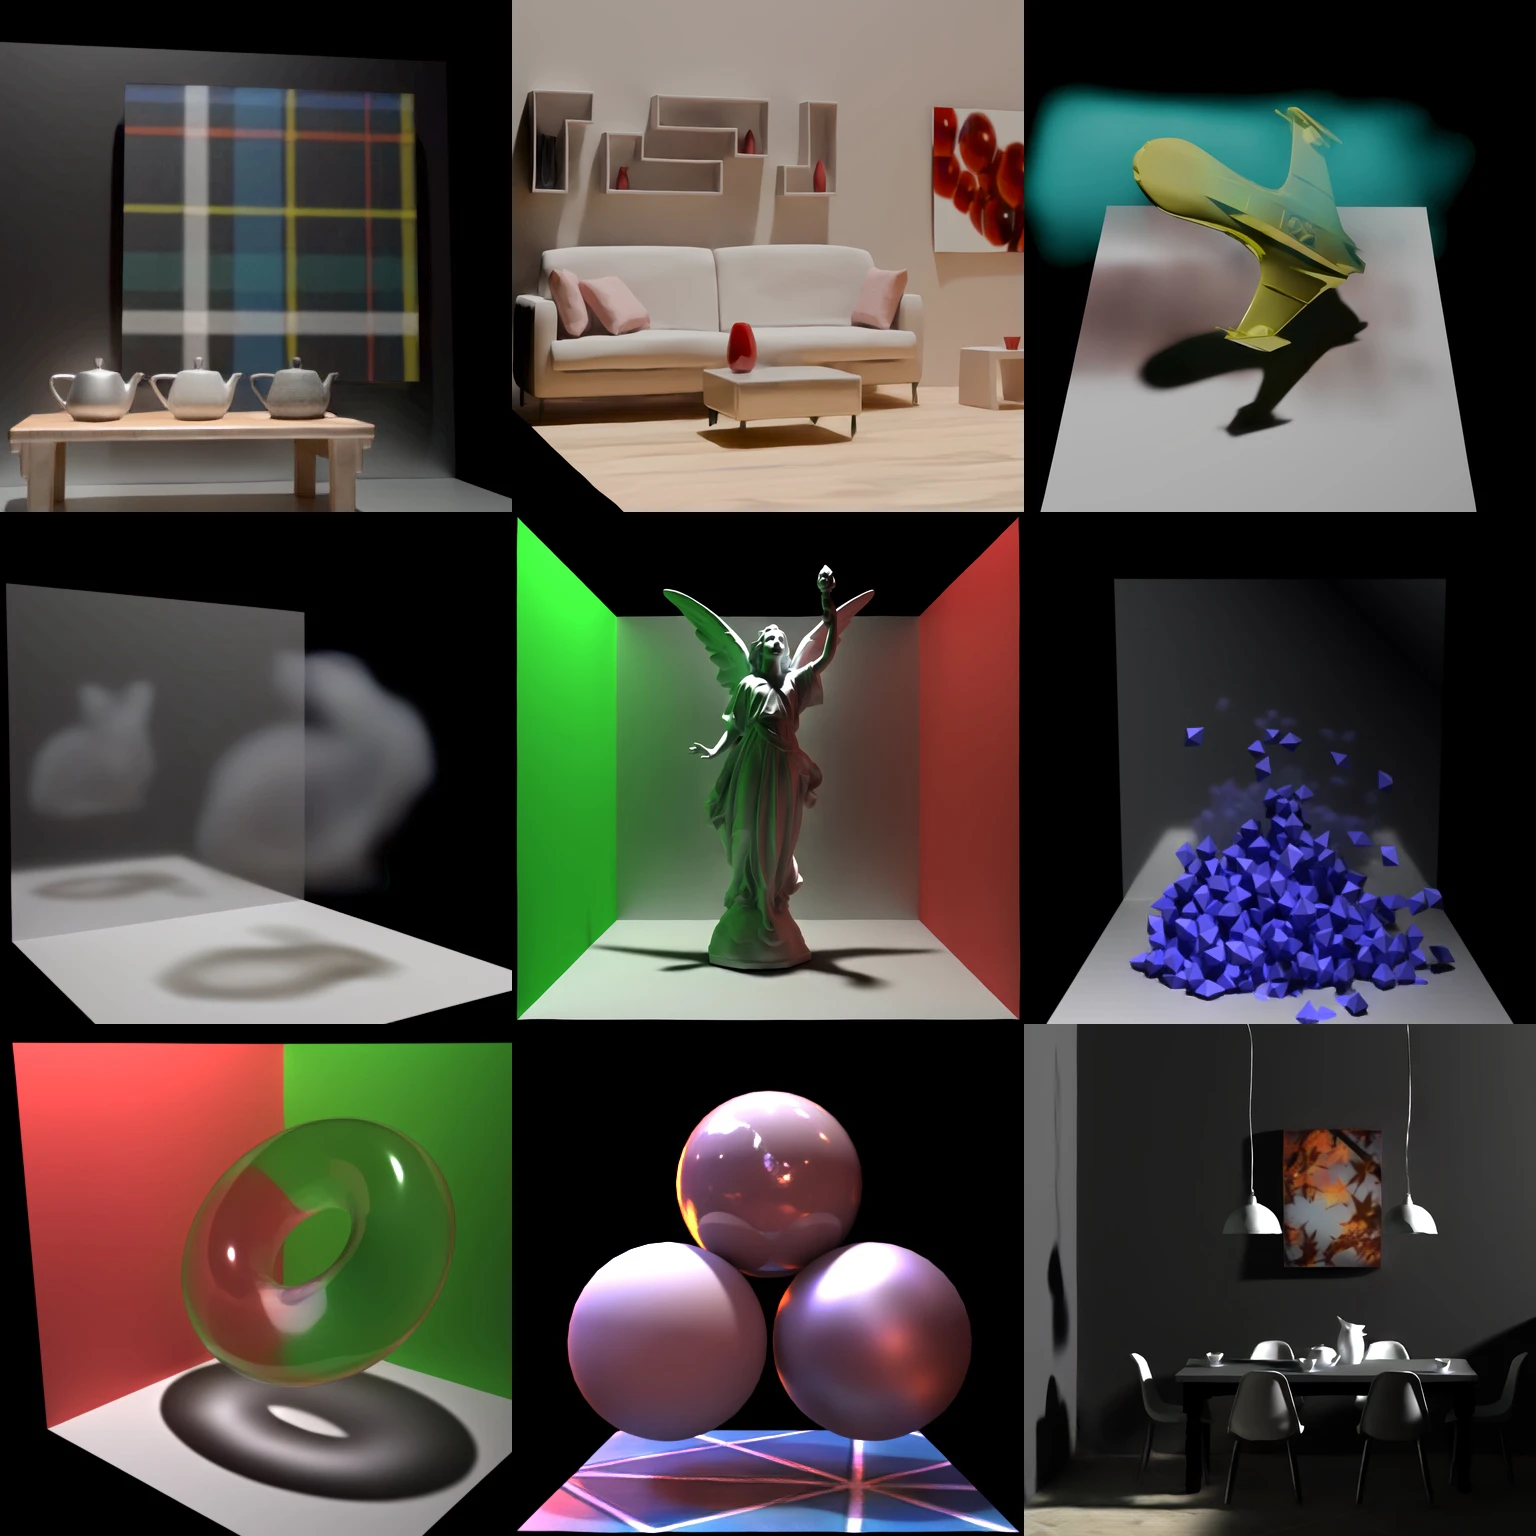
Stanford, Microsoft Research, William & Mary의 ECCV 2026 연구입니다. 기하, 재질, 조명, 카메라를 입력하고 같은 가중치로 다양한 장면을 렌더링합니다. 장면별 학습이 필요 없으며 네이티브 512·2048 모델이 공개되어 있습니다.
지원하는 빛 표현
V2는 굴절, 환경 조명, 볼륨 산란, 텍스처와 변위를 지원합니다. 유리는 배경을 바꾸고 HDR 환경은 장면을 밝히며 매질은 가시성과 빛 전달에 영향을 줍니다.
재질은 고정 GGX 파라미터뿐 아니라 학습한 외관 표현을 사용합니다. 접촉 그림자, 주변 반사와 유리 투과를 살펴보면 효과를 판단하기 좋습니다.
장면 데이터에서 픽셀로
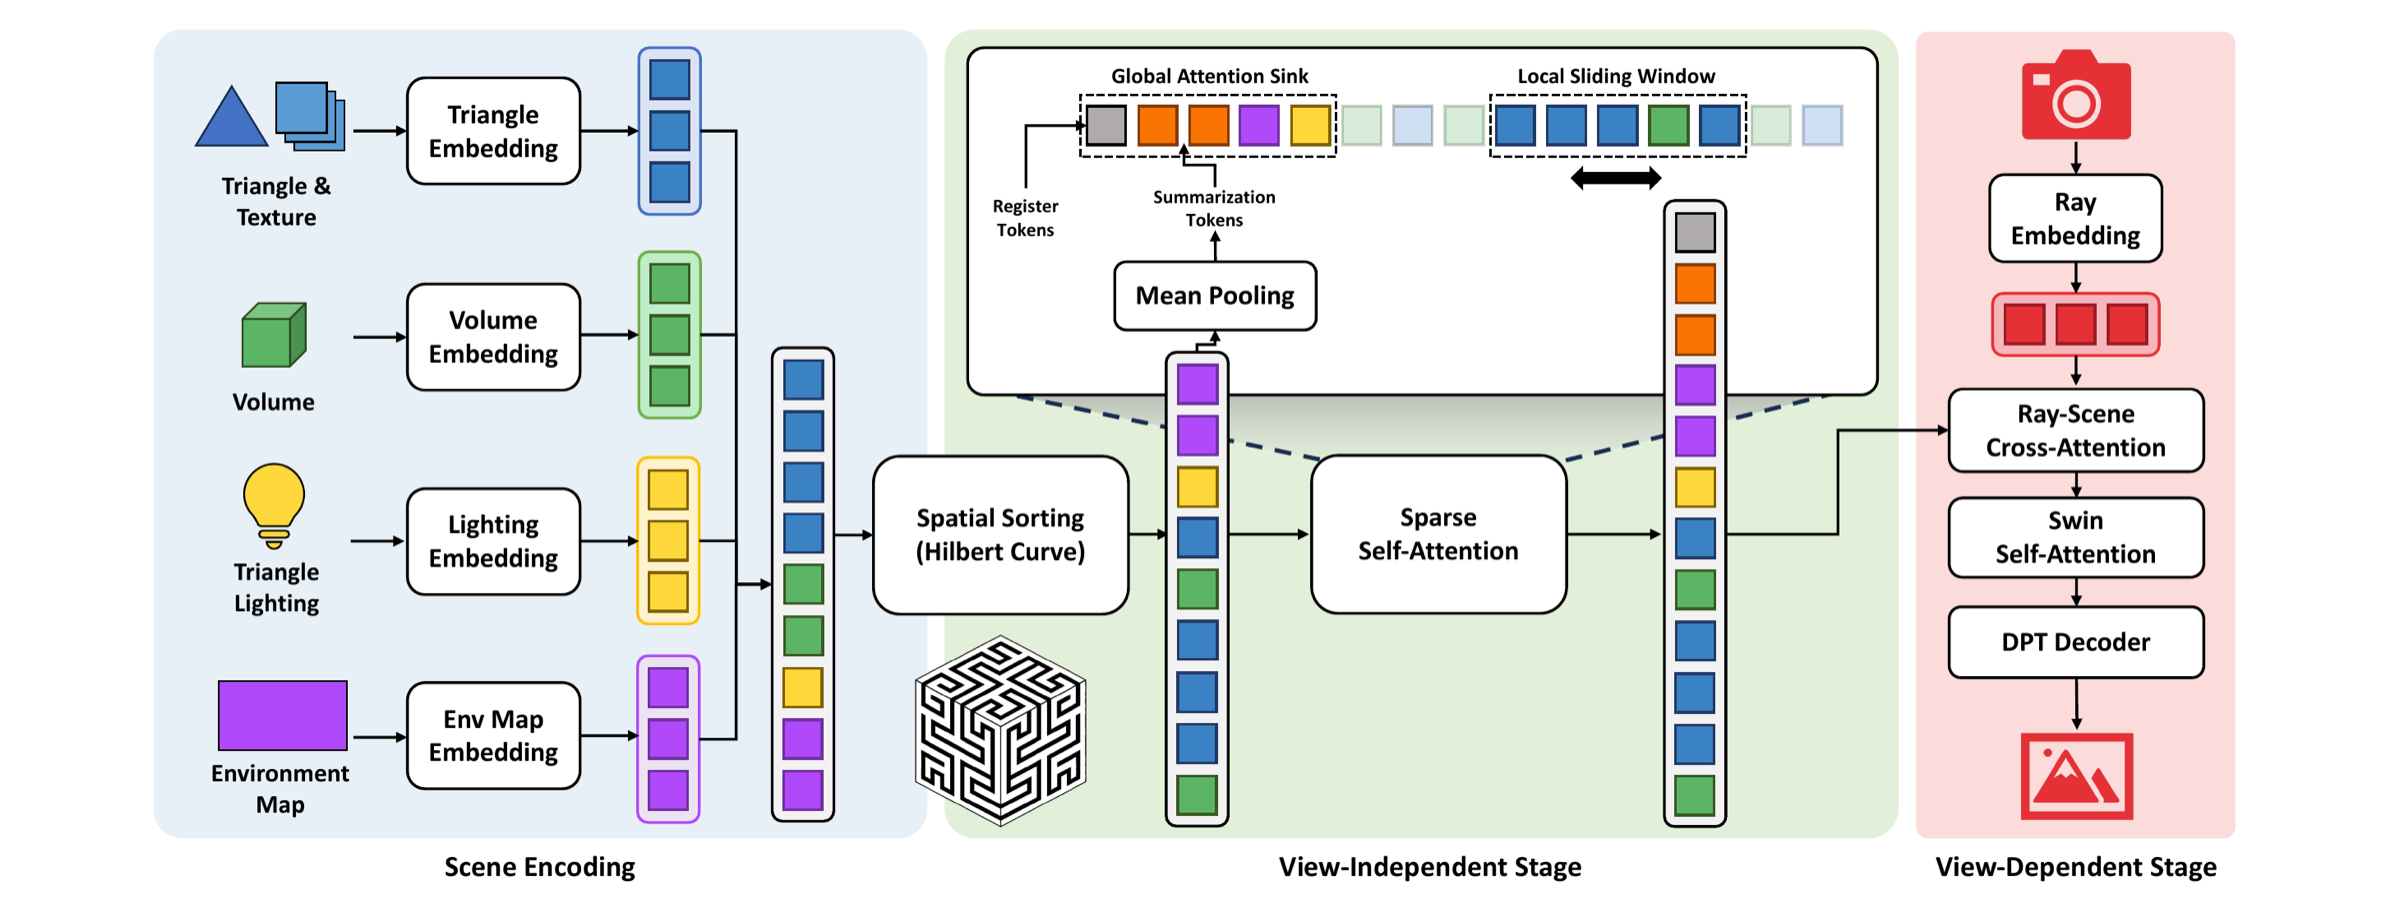
삼각형, 볼륨, 면광원, 환경 맵과 카메라 광선을 하나의 토큰 시퀀스로 만듭니다. 시점 독립 단계가 상호작용을 처리하고 시점 종속 단계가 카메라 이미지를 생성합니다.
로컬 어텐션과 글로벌 어텐션 싱크로 128K 이상의 프리미티브를 처리합니다. V1은 약 4K 삼각형 규모였습니다. 네트워크 내부에서 기존 레이 트레이서를 실행하는 대신 빛 전달을 학습합니다.
장면 준비와 렌더링
RenderFormer Studio, Python 3.10 또는 3.11과 공식 추론 환경을 사용하고 RF2 예제부터 시작하세요. Blender V2 확장은 prepared-frame 중간 데이터를 내보내며 데이터 파이프라인이 이를 처리된 H5로 생성·변환합니다.
아래 명령은 transformer_512를 사용합니다. 네이티브 2048 출력은 transformer_2048과 해당 해상도를 선택하세요. 재질·텍스처 구성 요소도 포함하므로 V1 로더가 아닌 V2 파이프라인을 사용합니다.
renderformer infer \
  --input processed/scene.h5 \
  --checkpoint RenderFormer/renderformer-v2 \
  --checkpoint-subfolder transformer_512 \
  --precision fp16 \
  --output-dir outputs
3D 작업 흐름에서의 위치
V2는 에셋 생성과 장면 구성 이후에 사용합니다. 물체를 Blender에 배치하고 재질과 조명을 설정한 뒤 데이터를 준비합니다. MoGe-3는 사진에서 보이는 기하를 복원하는 이전 단계의 도구입니다.
출력은 입력 장면의 이미지이며 새로운 메시가 아닙니다. V2로 재질과 조명을 탐색하고, 물체 에셋이 없다면 이미지 투 3D 생성기를 먼저 사용하세요.
생성·복원·렌더링의 차이
| 도구 | 입력 → 출력 | 역할 |
|---|---|---|
| 이미지 투 3D 생성기 | 참고 이미지 → 에셋 | 기하와 외관 생성 |
| MoGe-3 | 사진 → 깊이·보이는 기하 | 기하 복원 |
| RenderFormer-V1 | 삼각형 장면 → 이미지 | 작은 규모의 신경 렌더링 |
| RenderFormer-V2 | 혼합 프리미티브 → 이미지 | 굴절·환경광·텍스처·볼륨 |
자주 묻는 질문
GLB를 추론 명령에 바로 입력할 수 있나요?
공식 V2 입력은 준비된 H5 장면입니다. GLB를 Blender에 가져오고 장면을 설정한 뒤 V2 내보내기와 데이터 준비를 진행하세요.
장면마다 학습해야 하나요?
아니요. 같은 사전 학습 가중치로 다양한 장면을 렌더링합니다. 기하, 카메라, 조명을 바꿔도 장면별 학습은 필요하지 않습니다.
항상 Cycles보다 빠른가요?
공식 측정은 NVIDIA A100과 픽셀당 4,096 적응형 샘플의 Cycles를 사용합니다. 속도는 장면 규모, 해상도, 하드웨어와 품질 설정에 따라 달라집니다.